

 HarmonyOS开发|ArkTS UI颜色API通用规则

这两年大模型刷屏,大家都在聊"它能写代码、能聊天"。但很少有人讲清楚一件事:模型在读一段话的时候,到底是怎么知道该"重点看哪几个字"的?
这篇我们不堆公式,拆结构。把注意力机制(Attention)到 Transformer 这条线,一层层码明白。看懂它,你就看懂了 GPT、BERT 这些大家伙脚底下踩的第一块积木。
一、为什么模型需要"注意力"这种怪本事
早年的序列模型是 RNN 那一套:一个字一个字往里塞,看完第 1 个字得到个隐藏状态,再带着它看第 2 个字……一路往后传。
问题就出在这条"流水线"上。类比一下:让你读一部长篇小说,看到第 50 章的时候,第 1 章谁是谁你多半早忘了。RNN 也一样——句子一长,越靠前的信息被越 dil 得淡,等传到句尾,开头那个词基本就剩个影子。专业点说,这叫长程依赖丢失,训练时还会撞上梯度消失。
注意力机制干的事特别反直觉:它不让信息"流过"网络,而是让模型在生成每个输出时,直接回头去翻所有输入,谁跟当前任务相关就多瞄谁。
类比一下:做英语阅读理解,你不会先把整篇文章背下来再答题,而是看到题目,翻回原文找对应的那句话。注意力就是给模型配了这么一双"能随时翻回原文的手"。
一句话:RNN 靠"记性"撑全程,注意力靠"现查"——查谁相关,就给谁加权。
二、注意力机制的链路长什么样
把核心公式摊开,注意力其实就四步,名字叫"缩放点积注意力"(Scaled Dot-Product Attention):
Q (查询)  K (键)  V (值)
   │        │       │
   └─── 打分: Q·Kᵀ /√d_k ───┐
            │                │
            ▼                │
        softmax 归一化  ──► 注意力权重
            │                │
└──── 乘 V: 权重 × V ──► 输出 用大白话说就是:拿查询 Q 去和每个键 K 比一比相似度,相似度高的说明"这条信息跟我现在要找的有关",softmax 把它变成一组加起来等于 1 的权重,再用这组权重去给值 V 做加权平均。整条输入链路长这样:
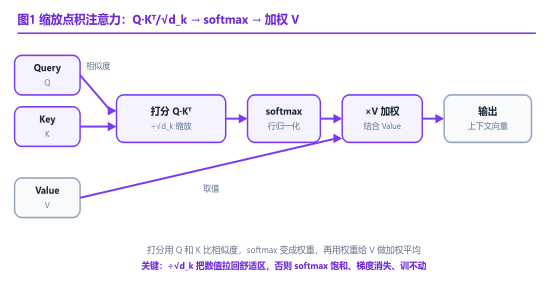
注意中间那个 ÷√d_k,叫缩放。点积的结果随着维度 d_k 变大,数值会飘得特别大,softmax 一进饱和区梯度就趋近于 0,训练直接卡死。除以根号 d_k 相当于把尺度拉回正常区间,这是 Transformer 能训得动的前提。
设计哲学就一句:先打分、再归一、最后按关注度取平均——谁重要多听谁的。
三、三个必须先懂的概念
如果你之前只写过 RNN 或全连接,下面这三个概念会反复出现,而且比"网络长啥样"更影响你调不调得动它。
1.Query / Key / Value —— 本质就是查字典
这三个字母把"查资料"这件事拆成了三角色:
- Q(Query):我现在想找什么,我手里的"检索意图"。
- K(Key):每条信息贴的标签,用来和 Q 比对"你俩匹不匹配"。
- V(Value):每条信息的真身,匹配上了才把它的内容取出来。
2.缩放点积 —— 为什么非得除以 √d_k
上面提过一次,这里说透。假设 Q 和 K 每个分量都是均值 0、方差 1 的独立随机变量,那它们点积的方差会随维度 d_k 线性增长。维度一大,点积的绝对值动辄几十上百。
softmax 对大数值极其敏感——一旦进入饱和区,输出要么全压在一个位置、要么梯度接近 0,模型学不动。除以 √d_k 正好把方差拉回 1,让 softmax 工作在"舒适区"。这不是拍脑袋,是数学上配平的。
3.多头注意力(Multi-Head)—— 一帮人分工看
单个注意力头只能学到一种"关注模式"。多头干的事,是把 Q/K/V 切成好几份,每份各算各的注意力,最后拼起来。
类比:几个人同时读同一段话,有人专门盯语法结构,有人专门盯指代关系("他"指代谁),有人专门盯远近依赖。多头就是让模型同时拥有好几双不同偏好的眼睛,看得更立体。
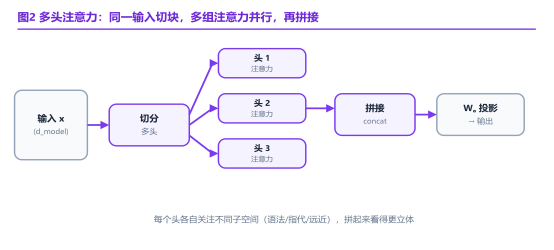
类比原话:单头像只用一只眼睛看人,多头是把几个视角拼成一张全景——哪个关系都漏不掉。
四、动手:实现缩放点积注意力 + 多头
下面这段代码看懂它,你就看懂了注意力的骨架。我们先写最底层的缩放点积注意力:
import torch
import torch.nn as nn
import torch.nn.functional as F
import math

# ---------- 1) 缩放点积注意力 ----------
def scaled_dot_product_attention(q, k, v, mask=None):
    # q,k,v 形状: (batch, heads, seq_len, d_k)
    d_k = q.size(-1)
     scores = torch.matmul(q, k.transpose(-2, -1)) / math.sqrt(d_k)  # QKᵀ / √d_k
    if mask is not None:
        scores = scores.masked_fill(mask == 0, float("-inf"))      # 不能看的位置压成 -inf
    attn = F.softmax(scores, dim=-1)                                # 每行归一化,权重和=1
    return torch.matmul(attn, v), attn                              # 加权求和 + 权重(方便可视化)

# ---------- 2) 多头注意力 ----------
class MultiHeadAttention(nn.Module):
    def __init__(self, d_model=512, num_heads=8):
        super().__init__()
        assert d_model % num_heads == 0, "d_model 必须能被 num_heads 整除"
        self.d_k = d_model // num_heads
        self.h = num_heads
        self.Wq = nn.Linear(d_model, d_model)
        self.Wk = nn.Linear(d_model, d_model)
        self.Wv = nn.Linear(d_model, d_model)
        self.Wo = nn.Linear(d_model, d_model)

    def forward(self, x, mask=None):
        B, N, _ = x.shape
        # 1) 投影出 Q K V,并拆成多个头
        q = self.Wq(x).view(B, N, self.h, self.d_k).transpose(1, 2)  # (B,h,N,d_k)
        k = self.Wk(x).view(B, N, self.h, self.d_k).transpose(1, 2)
        v = self.Wv(x).view(B, N, self.h, self.d_k).transpose(1, 2)
        # 2) 每个头各自算注意力,互不干扰
        out, attn = scaled_dot_product_attention(q, k, v, mask)
        # 3) 多头拼回 (B,N,d_model) 再投影一次
        out = out.transpose(1, 2).contiguous().view(B, N, -1)
return self.Wo(out), attn 跑一段小例子,直观感受"注意力权重"长什么样——4 个 token,随机初始化 QKV,看谁被谁关注:torch.manual_seed(0)
q = torch.randn(1, 1, 4, 8) # (B=1, heads=1, seq=4, d_k=8)
k = torch.randn(1, 1, 4, 8)
v = torch.randn(1, 1, 4, 8)
out, attn = scaled_dot_product_attention(q, k, v)
print("注意力权重(每行是一个 query 对各 key 的关注度):")
print(attn.squeeze().detach().round(3)) 你会看到每一行加起来等于 1,哪个位置数字大,说明那个 query 更"盯"着对应的 key。这就是注意力最朴素的样子。Transformer 还离不开位置编码——注意力本身是"打乱顺序也认不出区别"的(置换不变),得有人告诉它"字在哪儿"。这里用的是正弦位置编码:
def positional_encoding(seq_len, d_model):
    # 偶数维用 sin,奇数维用 cos,波长随维度指数增长
    pos = torch.arange(seq_len).unsqueeze(1)                       # (seq_len,1)
    div = torch.exp(torch.arange(0, d_model, 2) * -(math.log(10000.0)/d_model))
    pe = torch.zeros(seq_len, d_model)
    pe[:, 0::2] = torch.sin(pos * div)
    pe[:, 1::2] = torch.cos(pos * div)
return pe # 直接加到词向量上即可 再把它和前馈网络、残差、层归一化打包成一个 Transformer 块:class TransformerBlock(nn.Module):
def __init__(self, d_model=512, num_heads=8, dim_feed=2048, dropout=0.1):
super().__init__()
self.attn = MultiHeadAttention(d_model, num_heads)
self.ffn = nn.Sequential(
nn.Linear(d_model, dim_feed), nn.ReLU(), nn.Linear(dim_feed, d_model))
self.norm1 = nn.LayerNorm(d_model)
self.norm2 = nn.LayerNorm(d_model)
self.drop = nn.Dropout(dropout)
def forward(self, x, mask=None):
# Pre-LN:先归一化再算注意力,训练比原始 Post-LN 稳得多(现在主流都这么干)
a, _ = self.attn(self.norm1(x), mask)
x = x + self.drop(a) # 残差连接:保留原始信息
x = x + self.drop(self.ffn(self.norm2(x)))
return x 五、让注意力真正跑起来的几个实践要点
跑通上面几段只是起点,真正决定它好不好用,是这些细节:
- 位置编码不能省:注意力本身分不清"我爱你"和"你爱我",不喂位置信息,语序全乱。正弦编码能外推到比训练更长的序列,learnable 编码更灵活但长度得固定。
- 掩码(mask)是分水岭:解码器生成第 i 个词时绝不能偷看第 i+1 个词以后的内容,否则就是"考试提前看答案"。因果掩码(causal mask)把这些位置填 -inf;padding 位置也得 mask 掉,不然会被无效字符带偏。
- 维度要对齐:d_model 必须能被 num_heads 整除,不然 view 拆头时会直接报错——这是新手必踩的第一坑。
- 数值稳定靠减 max:自己手搓 softmax 时,先减去每行最大值再 exp,避免溢出。用 F.softmax 不用操心,但理解这一步能帮你debug。
- Pre-LN 优先于 Post-LN:原始论文把归一化放残差后面(Post-LN),训练容易不稳;现在基本都改成 Pre-LN(先归一化再进子层),收敛快还不容易炸。
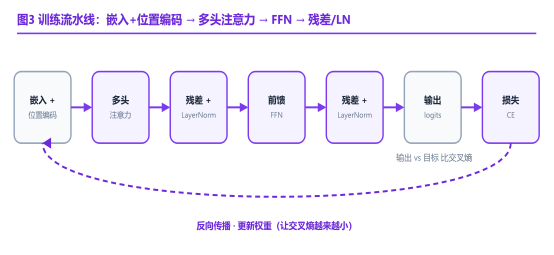
经验法则:注意力权重能不能"对得上人话里的指代关系",比 loss 曲线更低更能说明你搭对了。
六、从玩具到生产还要迈过的几道坎
- O(n²) 显存爆炸:注意力要对每个 query 和所有 key 算一遍,序列长度翻倍,计算量和显存直接翻四倍。长文本(几万字)根本塞不进一张卡。解法:稀疏注意力、分块计算,或者直接上 FlashAttention 把 IO 降下来。
- 位置编码外推差:正弦编码在训练长度内表现好,超出训练长度的"第 1001 个位置"它就懵了。RoPE、ALiBi 这类相对位置编码就是专门来救场的。
- 信息泄漏(解码器专属):忘了加因果掩码,模型训练时偷偷看了未来词,验证集指标漂亮得离谱——上线一用全露馅。这条坑新人几乎必踩一次。
- 头太多反而难训:盲目上 16 头、32 头,参数量上去了,但每个头的梯度被稀释,小数据上反而学不动。配合 dropout 才有用,别裸奔。
- 缩放忘了除 √d_k:手搓注意力时漏掉这步,点积数值过大,softmax 饱和,loss 死活不降——半天找不出原因。
七、小结
注意力的本质,是给模型换了一种"记忆方式":不再靠一个隐藏状态硬扛全程,而是每次都回头去全局查阅,谁相关就给谁加权。它用 Q·Kᵀ/√d_k → softmax → 加权 V 这四步,把"抓重点"这件事变成了可求导、可训练的操作。
但注意力只是零件。Transformer 把它和前馈网络、残差连接、层归一化一层层堆叠起来,彻底甩掉了 RNN 的递归结构——信息不再被"顺序"卡脖子,可以并行算,长距离依赖也不再稀释。后来的故事大家都熟了:GPT 只取解码器堆成生成模型,BERT 只取编码器堆成理解模型,底座全是这套东西。
你不需要一开始就把所有坑填平。好的实验结构是迭代出来的。先跑通 缩放点积注意力 → 多头 → 加位置编码 这条主线,再往上叠 Transformer 块,最后接个任务头,每一步都踩在前面那块积木上。