

 HarmonyOS开发|ArkTS UI颜色API通用规则

PostgreSQL 作为一款免费开源的对象关系数据库管理系统,凭借完善的 SQL 标准支持、多版本并发控制和企业级特性,正被越来越多企业纳入技术选型 。但很多开发者在实际使用中,往往只停留在"会写 SQL"的层面,对它的架构原理、索引选型和性能调优缺乏系统认知。本文将从 PostgreSQL 的核心特性讲起,逐步深入到索引优化、执行计划分析和高可用架构,帮你建立一套完整的实战知识体系。
一、为什么企业开始选择 PostgreSQL?
在开源关系型数据库的选择上,很多团队的第一反应是 MySQL。但当你面对复杂 SQL、高并发和数据分析混合负载时,PostgreSQL 往往是更明智的选择。
PostgreSQL 是一种几乎可以运行在各种平台上的免费开源对象关系数据库管理系统,拥有与企业级数据库相媲美的特性,如完善的 SQL 标准支持、多版本并发控制、时间点恢复、表空间机制、异步复制、嵌套事务、在线/热备份、复杂的查询优化器和预写日志容错技术。
它不是"另一个 MySQL",而是一套设计哲学完全不同的数据平台。理解这一点,是写出高效 PostgreSQL 应用的第一步。
二、PostgreSQL 与其他数据库的对比
2.1 与 MySQL 的核心差异
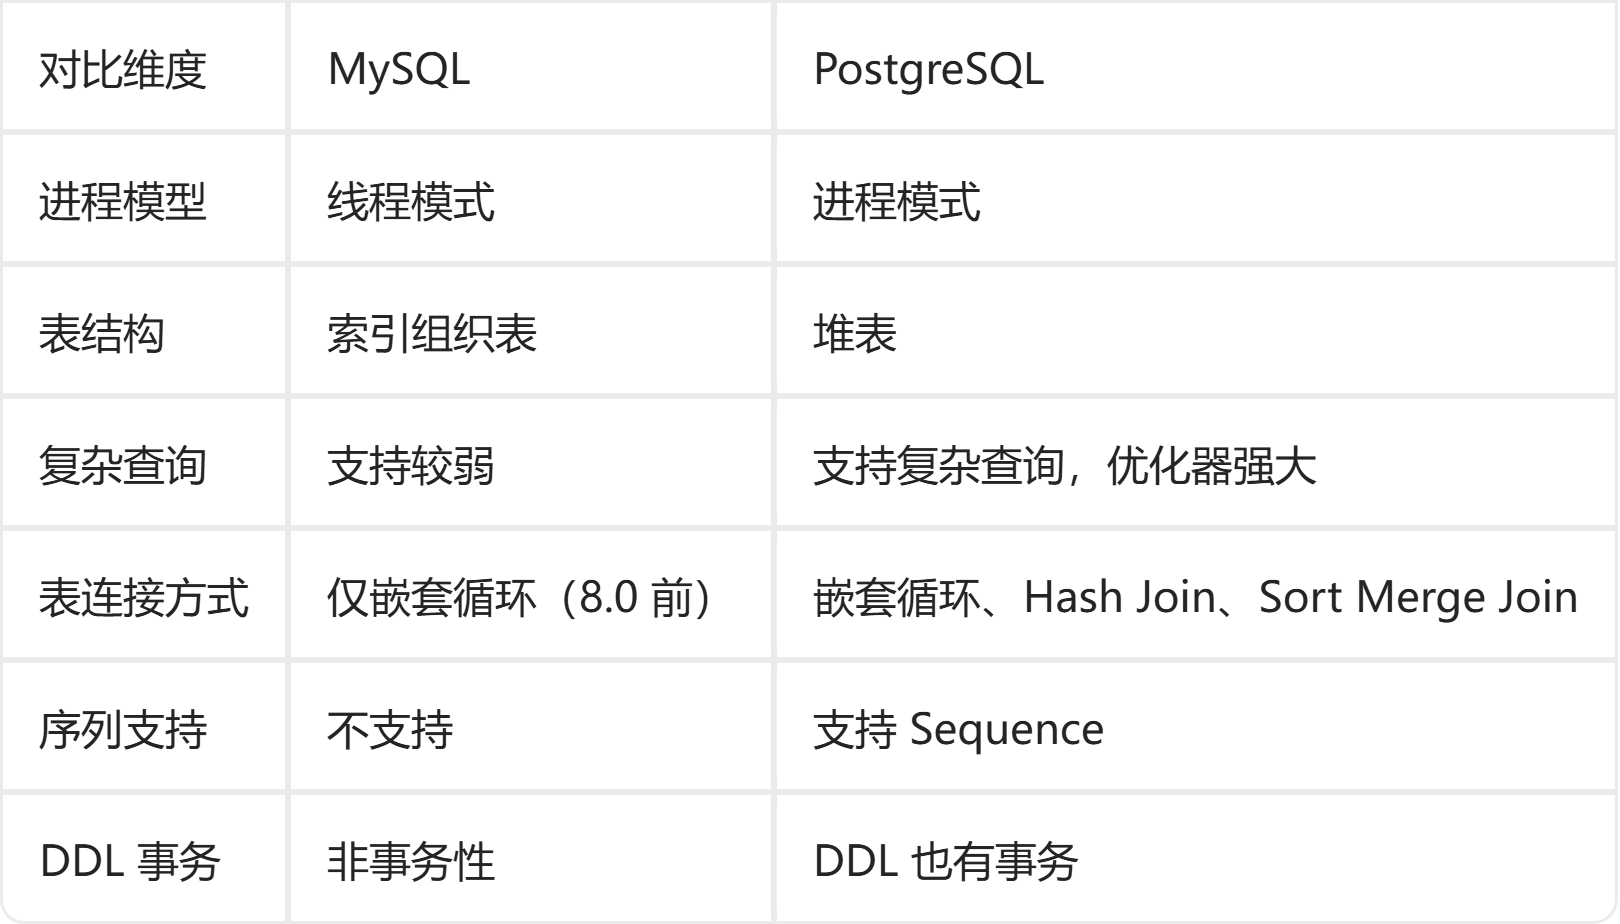
PostgreSQL 支持所有主流的多表连接查询方式,如 Nest Loop、Hash JOIN、Sort Merge JOIN 等,支持绝大多数 SQL 语法(如 CTE),并对正则表达式的支持极强、内置函数最为丰富。
在并发处理上,PostgreSQL 采用进程模式,对多 CPU 利用率较高;MySQL 采用线程模式,虽然支持更多连接,但在高并发场景下线程无法充分利用多核 CPU 的能力。
2.2 与 Oracle 的差异:多版本实现
PostgreSQL 与 Oracle 或 InnoDB 的多版本实现,最大区别在于最新版本和历史版本是否分离存储——PostgreSQL 不分,而 Oracle 和 InnoDB 分离。
这一设计带来几个直接好处:
- 没有回滚段:PostgreSQL 旧数据记录在原文件中,数据库异常 crash 后恢复时无需像 Oracle/InnoDB 那样同步 redo 和 undo,起不来的概率更低。
- 不会报 ORA-01555:由于旧数据直接记录在数据文件中而非回滚段中,避免了 Oracle 常见的 ora-01555 错误。
- 回滚更快:回滚并不删除数据,而 Oracle 与 InnoDB 回滚时需清理事务所做的修改并再次产生大量 redo 日志。
- WAL 日志更简单:Oracle 不仅要记录数据文件变化,还要记录回滚段变化。
代价是:最新版本与历史版本不分离存储,导致清理老旧版本需要更多扫描,VACUUM 代价较大——合理安排 VACUUM 即可缓解。
三、PostgreSQL 的 MVCC 与事务隔离
3.1 快照隔离如何工作
SQL 标准里定义了脏读、不可重复读、幻读三种异常,PostgreSQL 的快照隔离(SI)不会出现这三种问题。但 SI 无法实现真正的可串行化,可能出现写偏差等串行化异常。
PostgreSQL 从 9.1 版本之后添加了可串行化快照隔离(SSI),可以检测串行化异常并解决冲突,因此 9.1 之后的 PostgreSQL 提供了真正的 SERIALIZABLE 隔离等级。
3.2 隔离级别怎么选
PostgreSQL 默认使用读已提交(Read Committed),该级别并发性能高,但可能读取到中间状态数据;而可串行化(Serializable)提供更强的一致性保证,并发效率较低,适用于复杂业务逻辑,通常仅在必要时使用。
选型建议:绝大多数 OLTP 业务用默认的 Read Committed 即可,只有在涉及跨行约束、金融对账等强一致逻辑时,才考虑升级到 Serializable,并做好重试机制。
四、PostgreSQL 索引优化实战(重点)
索引是 PostgreSQL 性能调优的核心战场。用错索引类型,优化器再强也无能为力。
4.1 四种索引类型,各管一摊
PostgreSQL 提供多种索引类型:B-Tree、Hash、GiST 和 GIN,由于使用不同算法,每种索引类型都有其适合的查询类型,缺省时 CREATE INDEX 命令将创建 B-Tree 索引。
- B-Tree:主要用于等于和范围查询,当索引列使用 <、<=、=、>=、> 作为查询条件时,规划器都会考虑使用。使用 BETWEEN、IN、IS NULL 和 IS NOT NULL 的查询同样适用。但对于 LIKE、ILIKE、~ 这类模式匹配,仅当模式以常量开头时(如 col LIKE 'foo%')索引才生效,否则走全表扫描。
- Hash:只能处理简单的等于比较,性能并不比 B-Tree 强,尺寸和构造时间反而更差;更需注意的是,散列索引操作目前没有记录 WAL 日志,一旦数据库崩溃,必须用 REINDEX 重建。
- GiST:不是一种单独的索引类型,而是一种架构,可以在其上实现很多不同的索引策略。
- GIN:倒排索引,可以处理包含多个键的值(比如数组),既可以通过 GiST 实现全文搜索,也可以通过 GIN 实现。
4.2 部分索引:只索引你真正需要的数据
PostgreSQL 支持带任意谓词的部分索引,唯一约束是谓词的字段也要来自同样的数据表。关键点:只有当 PostgreSQL 能识别出查询的 WHERE 条件在数学上涵盖了索引谓词时,部分索引才能被用于该查询。
-- 只对未开票订单建索引
CREATE INDEX orders_unbilled_index ON orders(order_nr) WHERE billed is not true;

-- 这个查询会用到部分索引
SELECT * FROM orders WHERE billed is not true AND order_nr < 10000;

-- 这个查询则不会用到
SELECT * FROM orders WHERE order_nr = 3501;
部分索引与表达式索引是 PostgreSQL 相比 MySQL 的高级能力之一,在数据分布倾斜明显(如"状态=已完成"占 99%)的场景下能显著降低索引体积。
4.3 复合索引:字段顺序决定生死
使用复合索引应该谨慎。在大多数情况下,单一字段上的索引就已经足够了,并且还节约时间和空间;除非表的使用模式非常固定,否则超过三个字段的索引几乎没什么用处。
不同索引类型的复合表现差异很大:
GiST 复合索引:只有当第一个索引字段被包含在查询条件中时,才能决定扫描多少索引数据,其他字段只起限制作用。
GIN 复合索引:不受查询条件中使用了哪些索引字段子集的影响,无论哪种组合效率都相同。
4.4 组合多个索引与位图扫描
PostgreSQL 可以在查询时组合多个索引,在多个索引扫描之间组成 AND 和 OR 条件。系统会扫描每个需要的索引,在内存里组织一个 BITMAP,标记索引扫描出的数据在表中的物理位置,再进行 AND 或 OR 操作。
WHERE x = 42 OR x = 47 OR x = 53 OR x = 99
WHERE x = 5 AND y = 6
因为位图按物理顺序访问数据行,原索引的排序会消失,如果查询有 ORDER BY 还须额外排序。因此规划器有时宁可选择简单的单索引扫描。
五、用 EXPLAIN 定位 PostgreSQL 性能瓶颈
光有索引不够,得学会读懂执行计划。
EXPLAIN 命令用于分析查询的执行计划,通过展示各节点执行方式(顺序扫描、索引扫描、连接策略等)及预估开销(CPU 和 I/O 成本)帮助优化查询性能;EXPLAIN ANALYZE 还能提供实际执行时间等真实数据,验证预估准确性。
一个典型的连接查询计划长这样:
EXPLAIN SELECT * FROM tenk1 t1, tenk2 t2
WHERE t1.unique1 < 100 AND t1.unique2 = t2.unique2;

Nested Loop  (cost=2.37..553.11 rows=106 width=488)
  ->  Bitmap Heap Scan on tenk1 t1  (cost=2.37..232.35 rows=106 width=244)
        Recheck Cond: (unique1 < 100)
        ->  Bitmap Index Scan on tenk1_unique1  (cost=0.00..2.37 rows=106 width=0)
              Index Cond: (unique1 < 100)
  ->  Index Scan using tenk2_unique2 on tenk2 t2  (cost=0.00..3.01 rows=1 width=244)
Index Cond: ("outer".unique2 = t2.unique2) 检查索引是否真正被使用的四条建议:- 总是先运行 ANALYZE——它收集表中数值分布统计,规划器据此估算返回行数,缺乏真实统计会让检查失败。
- 使用真实数据做实验——用测试数据填充会导致索引评估偏离实际特征。
- 如索引未被使用,测试中强制其使用也许有价值。
- 强制使用索引后,用 EXPLAIN ANALYZE 对使用和不使用索引的查询分别计时。
六、PostgreSQL 高可用与生态工具
PostgreSQL 的高可用生态相当成熟,这是它在生产环境中站稳脚跟的重要原因。
Hot Standby:standby 在应用日志同步时还可以提供只读服务,这对做读写分离非常有用。
异步提交:把 synchronous_commit 设置为 false 即可开启。在很多允许宕机丢失少量数据的场景中特别合适,且异步提交不会导致数据损坏而数据库起不来的情况。
连接池:PostgreSQL 采用进程模式,若不使用连接池,高连接数场景下资源消耗较大。PostgreSQL 中有优秀的连接池软件,如 pgbouncer 和 pgpool,通过连接池可以支持大量连接。
集群与扩展软件:与 PostgreSQL 配合的开源软件很多,包括 pgpool、pgcluster、slony、plproxy 等,很容易做读写分离、负载均衡、数据水平拆分等方案,而这在 MySQL 下则比较困难。
此外,PostgreSQL 提供安装、编写插件的整体框架,如 create extension 语句可方便地装载插件,并通过 FDW 框架访问 Oracle、MySQL、SQLServer 等外部数据源。
七、PostgreSQL 适合什么场景?
PostgreSQL 不仅支持复杂的 SQL,还支持大量的分析函数,非常适合做数据仓库。
选型判断可以简化为三句话:
- 如果你仅仅想把数据库当作简单的存储软件,较复杂的功能都放到应用层实现,那么选 MySQL 或 NoSQL 都合适;
- 如果你的应用数据访问很简单(如大多数博客系统),后端用 MySQL 也很合适;
- 但如果你的应用不像博客系统那么简单,又不想消耗太多开发资源,那么 PostgreSQL 是一个很明智的选择——图片分享公司 Instagram 在使用 "Python + PostgreSQL" 架构后,仅十几个人就支撑了整个公司的业务。
八、常见问题(FAQ)
Q1:PostgreSQL 是免费的吗?
是。PostgreSQL 完全免费,采用 BSD 协议,即使修改后再拿去卖钱也没有人管,这表明它不会被其他公司控制。
Q2:PostgreSQL 支持哪些身份验证方式?
支持信任认证、口令认证、Kerberos 认证、基于 Ident 的认证、LDAP 认证、PAM 认证等丰富方法。
Q3:为什么我的 LIKE 查询用不上索引?
因为 B-Tree 索引仅在模式以常量开头时才生效,如 col LIKE 'foo%';col LIKE '%bar' 会执行全表扫描。
Q4:PostgreSQL 用什么命令行工具?
psql 是命令行工具,pgAdmin 是客户端 GUI 工具;空间回收用 Vacuum,统计信息更新用 Analyze。
九、总结
PostgreSQL 的价值不在于"免费",而在于它用一套优雅的架构(堆表 + MVCC + 强大的查询优化器 + 可扩展插件体系)同时满足了 OLTP 与 OLAP 的需求。
掌握 PostgreSQL 的关键路径清晰可见:
理解架构——进程模型、堆表、无回滚段的 MVCC;
吃透索引——B-Tree 管范围、GIN 管多值、部分索引省空间、复合索引看顺序;
善用工具——ANALYZE 打底、EXPLAIN ANALYZE 验证、VACUUM 保健康;
规划高可用——Hot Standby 读写分离 + pgbouncer 连接池 + 开源集群生态。
把这四步走扎实,PostgreSQL 就能真正成为你手中那把"让工作变得简洁和高效"的利器。