

 HarmonyOS开发|ArkTS UI颜色API通用规则

K近邻(K-Nearest Neighbors,简称KNN)是人工智能/机器学习领域最经典、最简单、最直观的监督学习算法之一,属于非参数、惰性学习模型,既可以完成分类任务,也能实现回归预测。它无需复杂训练、完全依赖数据分布规律,是AI入门必学核心算法,也是非线性问题建模的基础工具。
一、什么是K近邻(KNN)?
1. 通俗定义
“物以类聚,人以群分”的算法思想: 对于一个未知样本,找到它在数据集中距离最近的K个邻居,根据这K个邻居的类别(分类)或数值(回归),投票/平均得出未知样本的结果。 简单理解:看你身边最亲近的K个人是什么样,你就是什么样。
2. 严谨学术定义
K近邻是一种基于实例的监督学习算法,属于非参数模型(无固定模型结构、不学习固定参数)、惰性学习算法(无显式训练过程,预测时才计算)。 核心逻辑:通过度量未知样本与训练集样本的距离,选取前K个最近邻样本,依据邻居的统计特征完成分类决策或数值回归。
3. KNN的两大核心形态
KNN不局限于分类,同时支持回归,是少有的双任务通用基础算法:
| 类型 | 任务目标 | 决策规则 | 输出结果 |
| KNN分类 | 预测离散类别 | K个邻居多数投票 | 类别标签(如:垃圾邮件/正常邮件) |
| KNN回归 | 预测连续数值 | K个邻居取平均值/加权平均值 | 连续数值(如:房价、销量) |
4. 核心关键词解释
- K值:选取的最近邻样本数量,是KNN唯一的核心超参数;
- 近邻:与未知样本距离最短的训练样本;
- 距离度量:衡量样本间相似度的计算方式(核心是欧氏距离)。
二、K近邻的核心数学原理
KNN的数学逻辑极简,核心围绕距离计算、K值选择、决策规则三大模块展开:
1. 距离度量(判断样本相似度)
距离越小,样本越相似,这是KNN的核心依据。常用距离公式:
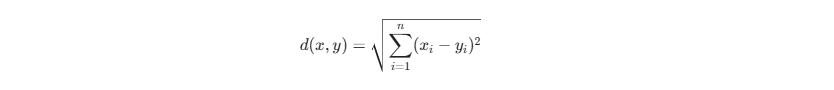
(1)欧氏距离(最常用,默认)
适用于连续型数值特征,二维/多维空间直线距离:
(2)曼哈顿距离(城市街区距离)
适用于网格型数据、离散特征:
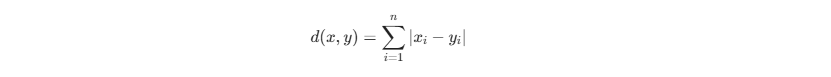
(3)闵可夫斯基距离
通用公式,欧氏距离(p=2)、曼哈顿距离(p=1)均为其特例:
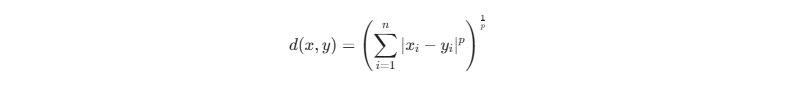
(4)切比雪夫距离
适用于极值敏感场景:
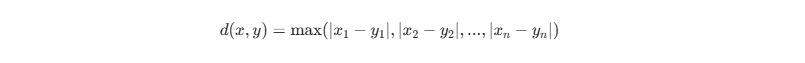
(5)余弦相似度
适用于高维稀疏数据(如文本、图像特征),衡量方向而非绝对距离。
2. K值选择(算法灵魂)
K值直接决定模型效果,是KNN唯一需要手动调优的超参数:
- K过小:模型过拟合,易受噪声/异常值干扰,泛化能力差;
- K过大:模型欠拟合,会把远处无关样本纳入,决策失真;
- 经验规则:分类任务优先选奇数(避免平票),K通常取1~20之间。
(1)KNN分类:多数投票法
K个邻居中,出现次数最多的类别即为未知样本的类别; 进阶:加权投票(距离越近,权重越高,解决样本不均衡问题)。
(2)KNN回归:均值法
K个邻居的目标数值取算术平均值,即为预测值; 进阶:加权平均(距离越近,权重越大,预测更精准)。
三、K近邻与人工智能的关系
KNN是人工智能技术体系的基础组成模块,层级隶属清晰,同时具备独特的算法价值:
1. 层级隶属关系
人工智能(AI) → 机器学习(ML) → 监督学习 → 非参数/惰性学习 → K近邻(KNN)
- 人工智能:让机器模拟人类智能的技术总称;
- 机器学习:AI的核心实现路径,从数据中学习规律;
- KNN:机器学习入门级非参数监督算法,是理解非线性建模的起点。
2. 核心关联:AI的“直观型基础算法”
- 惰性学习的典型代表 区别于线性回归、神经网络等急切学习算法(训练时拟合参数),KNN无训练过程,预测时才计算距离,是AI中“懒学习”的标杆案例。
- 非参数模型的入门教具 线性回归是参数模型(固定y = wx + b结构),KNN无固定模型结构,完全依赖数据分布,帮助理解AI模型的两大分类(参数/非参数)。
- 非线性问题的基础解决方案 线性回归只能拟合线性关系,KNN可天然拟合复杂非线性数据分布,是AI处理非线性问题的入门工具。
- 复杂AI模型的基准与组件。作为简单基准模型:复杂模型(深度学习、集成学习)落地前,用KNN测试 baseline;嵌入高级模型:聚类、推荐系统、异常检测算法中常集成KNN思想;迁移学习/小样本学习:KNN对小样本数据友好,是小样本AI的基础思路。
- AI分类/回归任务的衔接桥梁 一个算法同时适配分类+回归,帮助快速理解AI两大核心监督任务的本质区别。
3. 与线性回归的互补关系
- 线性回归:参数模型、线性拟合、急切学习、侧重数值预测;
- KNN:非参数模型、非线性拟合、惰性学习、分类回归通用; 二者共同构成AI入门的两大基础算法,覆盖线性/非线性、参数/非参数核心逻辑。
四、K近邻的核心作用
KNN的作用远超“分类预测”,覆盖建模、数据处理、验证、异常检测等全流程,是AI工程中的多功能工具:
1. 核心作用:分类与回归预测
- 分类:对离散类别做决策(如垃圾邮件识别、疾病诊断);
- 回归:对连续数值做预测(如房价、气温、销量预测)。
2. 异常值/离群点检测
当K=1时,若样本与最近邻距离极大,判定为异常数据,用于数据清洗、欺诈检测、设备故障预警。
3. 数据特征有效性验证
通过KNN的预测效果,判断特征是否有效:若KNN效果好,说明特征具备区分度;反之则特征无效。
4. 小样本数据建模
无需大量数据训练,少量样本即可完成预测,适配数据稀缺场景(如罕见病诊断、小众商品预测)。
5. 相似性检索与匹配
基于距离度量,实现相似样本查找(如相似图片检索、相似用户匹配、文本查重)。
6. 填补缺失值
利用邻居的均值/众数,填充数据集中的缺失值,是数据预处理的常用方法。
五、K近邻的应用方向/场景(全行业详尽列举)
KNN因简单、可解释、适配非线性,落地场景覆盖计算机视觉、金融、医疗、电商、安防、文本等几乎所有AI应用领域:
1. 计算机视觉(最核心场景)
- 手写数字识别(MNIST数据集经典案例);
- 图像分类(简单图像、商品图像分类);
- 图像相似检索(以图搜图、相似照片匹配);
- 人脸识别/表情识别(人脸特征距离匹配)。
2. 金融领域
- 信用风险评估:根据用户特征划分信用等级;
- 信用卡欺诈检测:识别异常交易行为;
- 贷款违约预测:判断用户是否会违约;
- 股票相似走势匹配:寻找历史相似行情辅助决策。
3. 医疗健康
- 疾病辅助诊断:根据患者指标匹配相似病例,判断病症;
- 肿瘤良恶性分类:细胞特征距离分类;
- 患者分型:根据生理指标划分病患类型;
- 药物相似性筛选:匹配药理特征相似的药物。
4. 电商与零售
- 推荐系统:相似用户/相似商品推荐(协同过滤核心思想);
- 用户分群:根据消费行为划分用户层级;
- 商品销量预测:KNN回归预测销量;
- 虚假订单检测:识别异常下单行为。
5. 文本与自然语言处理
- 垃圾邮件/短信分类;
- 文本情感分析(正面/负面/中性);
- 新闻文本分类(体育/娱乐/财经);
- 文本查重与相似文档检索。
6. 安防与物联网
- 行为异常检测:监控视频中异常行为识别;
- 传感器故障预警:工业传感器数据异常判定;
- 入侵检测:网络安全异常流量识别。
7. 地理空间与物流
- 地址匹配与地理分类;
- 物流配送路径规划:相似配送区域聚类;
- 商圈客流预测:KNN回归预测人流量。
8. 教育与人力资源
- 学生成绩预测:KNN回归预测考试分数;
- 学生分层:根据学习行为划分学习等级;
- 人才匹配:简历与岗位相似性匹配;
- 员工离职风险预测。
9. 其他场景
- 气象预测:气温、降雨量数值回归;
- 体育赛事:球员状态分类、比赛结果预测;
- 农业:农作物病虫害分类、产量预测。
六、K近邻关键补充知识点(易忽略+核心考点)
1. 惰性学习(懒学习)vs 急切学习
| 类型 | 代表算法 | 训练过程 | 预测速度 | 适用场景 |
| 惰性学习(KNN) | 无训练,存储全部数据 | 慢 | 小数据、小样本 | |
| 急切学习 | 线性回归、神经网络 | 训练拟合参数 | 快 | 大数据、高并发 |
2. 数据标准化/归一化的必要性
必须做! 特征量纲不同会严重扭曲距离计算(如:收入10000+、年龄30,收入会主导距离)。 常用方法:
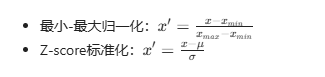
3. 维度灾难问题
KNN在高维数据(如图像、文本)中效果急剧下降,因为高维空间中所有样本距离趋近相等,失去区分度。 解决方案:PCA降维、特征选择、余弦相似度替代欧氏距离。
4. 样本不均衡的影响与解决
若某类别样本数量远多于其他类别,KNN会偏向多数类。 解决方案:
- 加权KNN(距离越近权重越高);
- 过采样/欠采样平衡数据;
- 调整K值。
5. K值优化方法
- 交叉验证(最常用):遍历K值,选择验证集准确率最高的K;
- 手肘法:绘制K-误差曲线,拐点为最优K;
- 经验法:K=√n (n为训练样本数)。
6. 算法效率优化(KD树/球树)
原始KNN需遍历全部数据,计算量极大(O(n)),大数据场景卡顿。 优化方案:
- KD树:对数据空间划分,减少距离计算次数(O(logn));
- 球树:适配高维数据,比KD树更高效;
- 局部敏感哈希(LSH):海量数据近似近邻搜索。
7. 加权KNN(高级改进)
普通KNN所有邻居权重相同,加权KNN中距离越近,权重越大,公式:
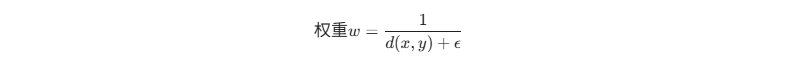
大幅提升预测精度,解决噪声干扰问题。
七、K近邻的标准工程实现流程
- 数据采集:收集带标签的训练数据(特征+标签/数值);
- 数据预处理:缺失值填充、异常值剔除、标准化/归一化、特征降维;
- 数据集划分:训练集+测试集(7:3/8:2);
- 超参数设定:选择K值、距离度量方式;
- 模型构建:初始化KNN模型(无需训练);
- 预测计算:计算测试样本与训练集的距离,选取K近邻;
- 决策输出:分类投票/回归平均;
- 模型评估:分类用准确率/精确率/召回率/F1,回归用MSE/RMSE/R²;
- 优化迭代:调整K值、距离度量、加权策略。
八、K近邻的优缺点(全面总结)
优点
- 算法极简,易实现易理解:无复杂数学推导,代码实现简单;
- 无需训练过程:惰性学习,直接存储数据即可预测;
- 天然适配非线性数据:无需手动特征变换,可拟合任意分布;
- 对异常值鲁棒(K>1时):单个异常值不会影响整体决策;
- 小样本数据友好:少量样本即可完成建模;
- 双任务通用:同时支持分类与回归,应用灵活;
- 可解释性较强:预测结果可通过邻居样本追溯原因。
缺点
- 预测速度慢,计算量大:大数据集下效率极低,不适合高并发场景;
- 内存占用高:需存储全部训练数据;
- 维度灾难:高维数据效果急剧下降;
- 对特征量纲敏感:必须标准化,否则距离失真;
- 样本不均衡时效果差:易偏向多数类;
- 无法处理特征重要性:所有特征权重相同;
- 不适合超大数据集:工业级海量数据需优化后使用。
九、KNN常用实现工具
- 入门/科研:Python Scikit-learn(KNeighborsClassifier/KNeighborsRegressor)、Scipy(距离计算);
- 可视化:Matplotlib/Seaborn(样本分布、近邻可视化);
- 大数据优化:PySpark(分布式KNN)、FAISS(Facebook高效相似检索库);
- 工程部署:轻量化模型可部署至移动端、嵌入式设备。